Como tratar erros em workflows do n8n para a automação não falhar em silêncio
Aprenda a tratar erros no n8n com error workflow, retry e monitoramento para evitar automações que param sem aviso em produção.
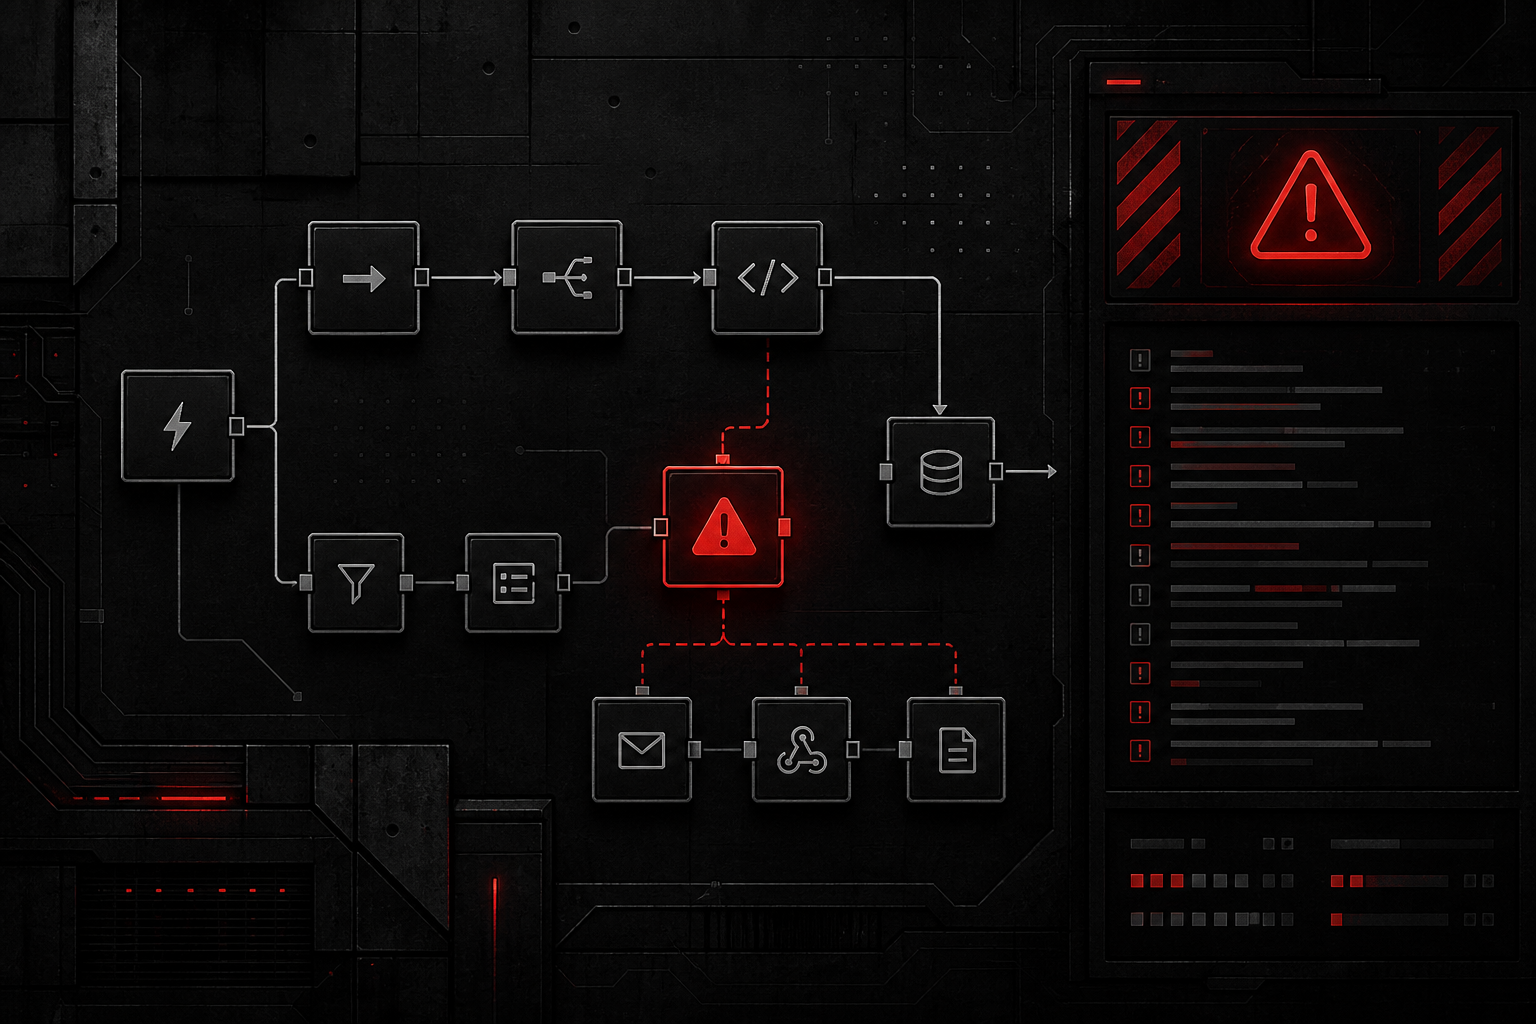
Tratar corretamente o tratamento de erros n8n evita que uma automação pareça saudável quando já quebrou. Sem captura, alerta e rastreabilidade, um workflow pode parar, seguir parcialmente ou repetir ações sem que ninguém perceba. O problema não está só na falha em si, mas na falha sem sinal operacional.
Por que workflows do n8n falham em silêncio
Em produção, o maior risco não é o erro visível. É o erro que acontece em um ponto do fluxo, é tratado de forma incompleta ou simplesmente não gera uma saída observável para o time responsável.
Erro capturado sem notificação
O n8n permite capturar falhas em alguns pontos do fluxo, mas isso não significa que alguém será avisado. Se o workflow desvia para uma rota de exceção e apenas registra algo localmente, o processo pode continuar sem que o dono do fluxo saiba que houve quebra. Isso é comum quando a automação foi desenhada para “não parar”, mas ninguém definiu quem recebe o alerta.
Execução parcial que parece concluída
Outro caso comum é a execução parcial. O workflow integra duas ou três etapas, conclui a etapa final e marca como finalizada, mas uma ação intermediária falhou. Se essa etapa intermediária era crítica, o sistema fica inconsistente. Tecnicamente, o fluxo terminou; operacionalmente, o processo não foi concluído.
Timeout, dados inválidos e falhas externas
Timeout de API, payload com campos ausentes e indisponibilidade de serviço externo são causas frequentes. O ponto é que cada uma exige uma resposta diferente. Timeout pode exigir nova tentativa. Dado inválido pede correção da entrada. Falha externa pode demandar fila, espera ou alerta. Se tudo for tratado do mesmo jeito, o workflow vira uma caixa preta.
O que o n8n oferece nativamente para tratar erros
O n8n tem recursos úteis, mas eles resolvem só uma parte do problema. O objetivo do error workflow n8n é capturar falhas, não substituir a arquitetura de monitoramento nem o desenho do processo.
Error Workflow
O Error Workflow é o mecanismo nativo para centralizar o tratamento de falhas de execução. Ele recebe contexto da execução que falhou e permite criar uma resposta padronizada, como registrar incidente, notificar responsável ou encaminhar dados para observabilidade. É útil quando você quer um ponto único de captura.
Continue On Fail
O Continue On Fail evita que um nó interrompa todo o fluxo ao encontrar erro. Isso ajuda quando a falha em um item não deveria impedir os demais. Porém, ele também pode esconder problemas se for usado sem critérios. O nó segue adiante, mas alguém precisa validar se o resultado final ainda é confiável.
Branches de erro e saída alternativa
Em alguns cenários, faz sentido construir uma rota alternativa para erros. Em vez de deixar o fluxo morrer, ele encaminha a falha para uma branch de notificação, log ou reprocessamento. Essa abordagem é melhor do que depender só de execução padrão, porque torna o erro parte explícita do desenho.
Limites do tratamento nativo
O limite do tratamento nativo é simples: ele lida com a execução, não com a operação. Se não houver dono, alerta, critérios de retry e rastreabilidade, a automação pode continuar falhando sem que isso seja percebido. É por isso que o tratamento nativo precisa ser combinado com automação bem definida e com a camada de infraestrutura que sustenta logs, disponibilidade e observabilidade.
Como desenhar tratamento de erros que evita silêncio operacional
Para evitar falha silenciosa, o fluxo precisa ser pensado com base em responsabilidade, ponto de captura e consequência operacional. Não basta “tratar o erro”. É preciso decidir o que o sistema faz quando ele erra.
Separar falha transitória de falha lógica
Falha transitória é a que pode se resolver sozinha, como indisponibilidade momentânea ou timeout. Falha lógica indica problema de regra, validação ou mapeamento de dados. Misturar os dois leva a repetição inútil ou mascaramento de bug. O fluxo deve identificar o tipo de falha antes de decidir entre retry, desvio ou parada.
Definir ponto de captura do erro
O ponto de captura precisa estar onde a falha é relevante. Às vezes, capturar no nó individual é suficiente. Em outros casos, o correto é centralizar no final do fluxo para ter visão do contexto completo. Se o erro afeta o resultado final, o ideal é que a execução gere uma evidência clara para o responsável pelo processo.
Registrar contexto mínimo da execução
Sem contexto, o erro vira apenas uma mensagem solta. Registre o nome do workflow, o nó que falhou, o identificador da execução, a origem da entrada e a ação que estava em andamento. Isso reduz tempo de diagnóstico e evita retrabalho. Em automações mais críticas, esse registro deve ir para um canal consultável, não apenas para o histórico interno.
Acionar alerta para falhas críticas
Nem toda falha merece interrupção operacional, mas toda falha crítica merece alerta. Se a automação controla pedido, financeiro, cadastro ou integração de sistema central, a ausência de alerta é risco direto. O dono do processo precisa saber que há algo quebrado, mesmo quando o workflow tenta seguir adiante.
Quando usar retry no n8n e quando não usar
O retry n8n é útil quando o problema é externo e temporário. Ele é ruim quando o problema é interno, repetível e estrutural. Se você repete uma falha lógica, só repete o custo.
Falhas temporárias de API e rede
Use retry quando a falha parece relacionada à disponibilidade, latência ou limite momentâneo de serviço. Um endpoint pode falhar por alguns segundos e voltar sem intervenção. Nesses casos, uma nova tentativa evita perda de execução sem exigir ação manual imediata.
Erros persistentes de validação
Se a falha ocorre por campo obrigatório ausente, formato inválido ou regra de negócio quebrada, retry não ajuda. O dado continuará errado. Nesse caso, o mais correto é parar a execução, registrar o motivo e encaminhar para correção ou revisão da origem.
Backoff, limite de tentativas e risco de duplicidade
Retry sem limite pode piorar o problema. É importante definir quantidade máxima de tentativas e, quando possível, um intervalo progressivo entre elas. Também é preciso considerar duplicidade: se a primeira tentativa pode ter executado parcialmente do outro lado, repetir sem idempotência pode gerar ação duplicada. Em integrações sensíveis, isso deve ser desenhado com critério.
Monitoramento de automação: o mínimo para não depender da sorte
Tratamento de erro sem monitoramento ainda deixa a operação cega. Se ninguém enxerga o estado do fluxo, a automação pode degradar por dias antes de ser percebida. É aqui que o monitoramento de automação deixa de ser conforto e vira requisito operacional.
Alertas por falha crítica
O mínimo é ter alerta quando um workflow crítico falha. Esse alerta deve chegar ao time certo, com informação suficiente para triagem. Não precisa ser sofisticado para ser útil. Precisa ser confiável e acionável.
Verificação de execução parada
Além do erro explícito, existe a execução parada no meio do caminho. Isso acontece quando uma automação fica sem conclusão e sem falha visível para quem opera. A revisão periódica do histórico ajuda, mas o ideal é ter verificação de ausência de execução esperada, principalmente em fluxos recorrentes.
Revisão de logs e histórico
Histórico de execução não é só ferramenta de debug. É base de governança. Ele mostra padrões de falha, pontos recorrentes de instabilidade e nós que concentram incidentes. Se o log não é revisado, o mesmo problema volta como se fosse novo.
Sinais que indicam degradação do fluxo
Mesmo sem falha total, o fluxo pode estar degradando. Atrasos repetidos, aumento de retries, mudança no volume de erro e crescimento de execuções parciais são sinais de que algo está piorando. Em automação empresarial, esse tipo de degradação costuma aparecer antes da interrupção completa e é o que mais custa detectar tarde demais.
Checklist prático para revisar um workflow em produção
Antes de considerar um workflow pronto, revise o desenho com foco em erro, responsabilidade e visibilidade. Esse checklist ajuda a reduzir surpresa em operação e vale para qualquer integração crítica.
Campos obrigatórios
Confirme quais entradas são obrigatórias e onde elas são validadas. Se um campo faltar, o fluxo deve parar com mensagem útil ou seguir por uma branch clara de exceção. Não deixe a validação depender só do nó final.
Saídas de erro
Todo ponto relevante do fluxo precisa ter uma saída de erro prevista. Se um nó falhar, o comportamento deve ser conhecido: retry, desvio, parada ou notificação. Fluxo sem saída de erro definida vira manutenção reativa.
Notificação
Defina quem recebe alerta, em que condição e com que nível de detalhe. O alerta deve responder às perguntas básicas: o que falhou, onde, quando e qual a consequência provável.
Retry
Use retry apenas nos pontos que realmente toleram nova tentativa. Documente onde ele existe e por quê. Se o retry foi colocado para “segurar a pancada”, revise, porque isso pode esconder falhas de lógica e aumentar custo operacional.
Rastreabilidade
Toda execução crítica precisa ser rastreável de ponta a ponta. Sem identificador, contexto e histórico, o diagnóstico fica lento. Rastreabilidade é o que conecta falha técnica ao processo de negócio.
Quando pedir apoio para revisar a arquitetura do n8n
Há um ponto em que o problema deixa de ser ajuste de nó e vira arquitetura. Quando isso acontece, insistir no improviso só aumenta o risco.
Fluxos críticos sem dono técnico
Se o workflow é crítico, mas ninguém sabe exatamente como ele foi montado, o risco operacional é alto. Falta dono, falta revisão e falta clareza sobre o que fazer quando quebra.
Erros recorrentes sem causa clara
Se o mesmo erro aparece repetidamente e a causa não está evidente, vale revisar desenho, dependências e observabilidade. Muitas vezes o problema não está no erro em si, mas na forma como o fluxo captura e expõe a falha.
Ambiente sem monitoramento confiável
Quando não há alerta, log suficiente ou revisão regular, o fluxo depende de sorte para continuar funcionando. Nesse cenário, vale buscar apoio para estruturar o processo com mais segurança. Se você precisa revisar esse desenho, use o Solicitar diagnóstico para avaliar o fluxo com foco técnico e operacional.
Conclusão
O tratamento de erros n8n só funciona de verdade quando sai do nível do nó e entra no nível da operação. O fluxo precisa saber falhar, mas também precisa avisar, registrar, permitir triagem e evitar repetição indevida. Sem isso, a automação parece ativa enquanto o processo já está comprometido. Se você quer revisar o seu desenho com foco em risco, rastreabilidade e monitoramento, faça o Solicitar diagnóstico.
Perguntas frequentes
O que é error workflow no n8n?
É o fluxo usado para capturar e tratar falhas de execução em um ponto central. Ele recebe contexto do erro e permite registrar, notificar ou redirecionar a ocorrência, evitando que a falha fique sem visibilidade.
Continue On Fail é suficiente para evitar falha silenciosa?
Não. Ele impede que um nó pare todo o fluxo, mas não garante alerta, rastreabilidade nem validação do resultado final. Sem monitoramento e critérios de negócio, a automação pode continuar errando sem ninguém perceber.
Quando devo usar retry no n8n?
Use retry quando a falha for transitória, como instabilidade de rede, timeout ou indisponibilidade momentânea de API. Não use retry para erro de validação, dado ausente ou regra de negócio quebrada, porque isso só repete a mesma falha.
Como saber se um workflow parou sem gerar erro visível?
Você precisa combinar histórico de execução, controle de recorrência esperada e alerta por ausência de evento. Quando um fluxo recorrente deixa de executar ou passa a concluir parcialmente, isso costuma indicar parada silenciosa ou degradação operacional.
Quais alertas devo configurar para automações críticas?
O mínimo é alerta de falha crítica, alerta de execução parada e alerta de repetição anormal de retries. Em fluxos mais sensíveis, também vale alertar execução parcial, atraso acima do esperado e falhas em nós que impactam o resultado final.
Fontes e referências
- Handle errors gracefully, n8n Docs
- Understand executions, n8n Docs